Diese Anleitung zeigt den Weg vom evasys-Export bis zu den fertigen PDF-Berichten. Ein Auswertungsprojekt besteht aus drei Dateien, die nacheinander und unterschiedlich oft ausgeführt werden:
| Datei | Wann? | Was passiert? |
|---|---|---|
vorbereitung.R |
einmal pro Befragung | Daten einlesen und bereinigen, festlegen, welche Fragen in welchen Bericht kommen, Schreibweisen prüfen, speichern |
bericht.qmd |
einmal pro Bericht | Daten laden, auf den Bericht einschränken, Fragen auswerten |
alle-berichte-rendern.R |
am Ende |
bericht.qmd für jede Zeile der Berichtstabelle zu einem
PDF rendern |
Die Vorlage set-template enthält
genau diese drei Dateien als lauffähiges Beispiel
(beispiele/vorbereitung.R,
beispiele/kohorte.qmd,
beispiele/alle-berichte-rendern.R) und dazu das Layout der
Berichte.
Nur ein einziger Bericht? Dann entfallen Berichts- und Regeltabelle: Die Daten werden direkt im Bericht eingelesen, und die Schritte 1.3, 1.4 sowie die Abschnitte zu Schaltern und Filtern in Teil 2 fallen weg.
1. Vorbereitung (vorbereitung.R, einmal pro
Befragung)
Die Vorbereitung läuft einmal, bevor der erste Bericht erstellt wird. Ihr Ergebnis sind zwei Dateien: die aufbereiteten Daten und die Berichtstabelle. Die Beispiele hier nutzen die fiktiven Dateien, die im Paket liegen.
1.1 Den evasys-Export einlesen
evasys exportiert die Antworten (Rohdaten) und ein Codebuch mit
Fragetexten, Fragetypen und Antwortoptionen, jeweils als CSV-Datei.
evasys_read_data() liest beide ein:
rohdaten <- system.file("extdata", "beispiel_evasys_rohdaten.csv", package = "setanalysis")
codebuch <- system.file("extdata", "beispiel_evasys_codebuch.csv", package = "setanalysis")

daten <- evasys_read_data(rohdaten, codebuch)
names(daten)
#> [1] "semester"    "zufrieden"   "abschluss_1" "abschluss_2" "kommentar"
#> [6] "alter"
Jede Variable trägt danach vier Attribute aus dem Codebuch. Auf sie greifen alle Auswertungsfunktionen zu:
attributes(daten$zufrieden)
#> $label
#> [1] "Ich bin mit dem Studium zufrieden."
#>
#> $nr
#> [1] "1.2"
#>
#> $type
#> [1] "sk"
#>
#> $labels
#>       trifft gar nicht zu
#>                         1                         2                         3
#>                                                                trifft voll zu
#>                         4                         5                         6
#> kann ich nicht beurteilen
#> 7-
label: Fragetext, wird im Bericht zur Überschrift, -
nr: Fragenummer im Fragebogen (für die Schalter, siehe 1.3), -
type: Fragetyp,"sc"(Single Choice),"mc"(Multiple Choice),"sk"(Skala) oder"open/num"(offene oder numerische Frage), -
labels: Antwortcodes mit ihren Texten (nur Single Choice und Skalen).
Außerdem entfernt evasys_read_data() das Präfix
[FILTER] aus Spaltennamen und ersetzt Platzhalter wie
"-", "." oder "[Freitextfeld]" in
offenen Antworten durch NA. Ohne Pfadangaben öffnet sich in
RStudio ein Dialog zur Dateiauswahl.
1.2 Daten bereinigen (bei Bedarf)
Hier ist Platz für Korrekturen, die für alle Berichte gelten, z. B. Namen in offenen Antworten unkenntlich machen:
daten$kommentar <- gsub("Frau Beispiel", "[Name entfernt]", daten$kommentar, fixed = TRUE)1.3 Festlegen, welche Fragen in welchen Bericht kommen
Oft entstehen aus einer Befragung viele Berichte, z. B. einer pro Studiengang, und nicht jede Frage gehört in jeden Bericht. Das regeln zwei Excel-Tabellen.
Die Berichtstabelle enthält eine Zeile pro Bericht mit den Merkmalen, nach denen sich die Berichte unterscheiden. Die erste Zeile ist immer der Master-Bericht mit allen Fragen (zur Kontrolle):
berichte_pfad <- system.file("extdata", "beispiel_berichte.xlsx", package = "setanalysis")
regeln_pfad <- system.file("extdata", "beispiel_regeln.xlsx", package = "setanalysis")

readxl::read_excel(berichte_pfad)[, c("Code", "Art", "Abschluss", "Studiengang")]
#> # A tibble: 6 × 4
#>   Code                     Art          Abschluss                   Studiengang
#>   <chr>                    <chr>        <chr>                       <chr>
#> 1 MASTER                   alles.master alle                        alle
#> 2 Gesamtbericht            alles        alle                        alle
#> 3 B.Sc._Musterwissenschaft Studiengang  Bachelor of Science (B.Sc.) Musterwisse…
#> 4 M.Sc._Musterwissenschaft Studiengang  Master of Science (M.Sc.)   Musterwisse…
#> 5 B.A._Beispielkunde       Studiengang  Bachelor of Arts (B.A.)     Beispielkun…
#> 6 Sonderauswertung         speziell     alle                        alle
Die Regeltabelle enthält eine Zeile pro Frage:
inkl.2.1 steht für Frage 2.1, die Bedingung daneben ist
R-Code mit den Spaltennamen der Berichtstabelle. Zusätzlich gibt es
immer TRUE und immer FALSE.
header-Zeilen stehen für ganze Abschnitte; ein Abschnitt
erscheint automatisch, sobald eine seiner Fragen erscheint.
as.data.frame(readxl::read_excel(regeln_pfad))
#>   Variable                         TRUE (in einen Bericht rein), wenn…
#> 1 inkl.1.1                                                  immer TRUE
#> 2 inkl.1.2                                           Art != "speziell"
#> 3 inkl.1.3 Abschluss == "Bachelor of Science (B.Sc.)" | Art == "alles"
#> 4 inkl.2.1                         Studiengang == "Musterwissenschaft"
#> 5 inkl.2.2                                                 immer FALSE
#> 6 inkl.3.1                                           Art == "speziell"
#> 7  header1                         eine der inkl.1.x-Variablen == TRUE
#> 8  header2                         eine der inkl.2.x-Variablen == TRUE
#> 9  header3                         eine der inkl.3.x-Variablen == TRUE
input_tabelle() wertet die Regeln für jeden Bericht aus
und hängt pro Regel eine Spalte mit TRUE oder
FALSE an die Berichtstabelle an. Diese Spalten sind die
Schalter, mit denen jeder Bericht später seine Fragen
auswählt:
berichte <- input_tabelle(berichte_pfad, regeln_pfad)
berichte[, c("Code", "inkl.1.3", "inkl.2.1", "header2", "inkl.3.1", "header3")]
#> # A tibble: 6 × 6
#>   Code                     inkl.1.3 inkl.2.1 header2 inkl.3.1 header3
#>   <chr>                    <lgl>    <lgl>    <lgl>   <lgl>    <lgl>
#> 1 MASTER                   TRUE     TRUE     TRUE    TRUE     TRUE
#> 2 Gesamtbericht            TRUE     FALSE    FALSE   FALSE    FALSE
#> 3 B.Sc._Musterwissenschaft TRUE     TRUE     TRUE    FALSE    FALSE
#> 4 M.Sc._Musterwissenschaft FALSE    TRUE     TRUE    FALSE    FALSE
#> 5 B.A._Beispielkunde       FALSE    FALSE    FALSE   FALSE    FALSE
#> 6 Sonderauswertung         FALSE    FALSE    FALSE   TRUE     TRUE
An dieser Stelle lassen sich auch weitere Angaben ergänzen, z. B. der Titel oder der Dateiname jedes Berichts:
berichte$Dateiname <- paste0("Befragung2024_", berichte$Code)1.4 Schreibweisen prüfen
Jeder Bericht wird später über die Einträge der Berichtstabelle
gefiltert, z. B. alle Antworten mit dem Abschluss „Bachelor of Science
(B.Sc.)“. Steht dieser Text in der Tabelle anders als in den Daten,
bleibt der Bericht leer. label_test() vergleicht beide
Schreibweisen, hier am Beispiel der Lehrveranstaltungsevaluation in
BspDaten, deren Berichtstabelle einen Tippfehler
enthält:
label_test(BspDaten$pInfo$FB.txt.falsch, BspDaten$dataLVE$Teilbereich)
#> [1] "Der Eintrag \"Angewandte Fktion - SoSe24\" aus der Berichtstabelle kommt nicht in gleicher Schreibweise in der Variable vor."2. Der Bericht (bericht.qmd, einmal pro Bericht)
Der Bericht ist ein Quarto-Dokument. Er wird für jeden Bericht einmal
gerendert; welcher Bericht gerade entsteht, sagt der Parameter
i (die Zeile der Berichtstabelle). Ein vollständiges
Gerüst:
---
title: "Befragung 2024"
format: typst
params:
  i: 1 # Zeile der Berichtstabelle (1 = Master-Bericht)
---

```{r}
#| include: false
library(setanalysis)

# (1) Einstellungen für alle Auswertungen
change_analysis_defaults(color.bars = "#507289", open.appendix = TRUE)

# (2) Vorbereitete Daten laden (aus vorbereitung.R)
daten <- readRDS("daten.rds")
berichte <- readRDS("berichte.rds")

# (3) Zeile dieses Berichts wählen und die Schalter als Variablen setzen
bericht <- berichte[params$i, ]
schalter <- grep("^(inkl|header)", names(bericht), value = TRUE)
list2env(as.list(bericht[schalter]), envir = environment())

# (4) Daten auf diesen Bericht einschränken
#     (hier angenommen: Single-Choice-Frage "abschluss", deren Antworttexte
#     den Einträgen der Spalte Abschluss in der Berichtstabelle entsprechen)
zeilen_waehlen <- function(daten, auswahl) {
  neu <- daten[auswahl, , drop = FALSE]
  for (spalte in names(daten)) {
    mostattributes(neu[[spalte]]) <- attributes(daten[[spalte]])
  }
  neu
}
if (bericht$Abschluss != "alle") {
  codes <- attr(daten$abschluss, "labels")
  daten <- zeilen_waehlen(daten, daten$abschluss == codes[bericht$Abschluss])
}
```

# 1. Studium

```{r}
#| eval: !expr header1
#| output: asis
# (5) Fragen auswerten
merge_sc(daten$semester, nr = "1.1")
merge_sk(daten$zufrieden, nr = "1.2", alt1 = "kann ich nicht beurteilen", alt1.num = 7)
merge_mc(daten[, c("abschluss_1", "abschluss_2")], nr = "1.3")
```

# 2. Anmerkungen

```{r}
#| eval: !expr header2
#| output: asis
merge_open(daten$kommentar, nr = "2.1")
```

```{r}
#| output: asis
# (6) Anhang mit den offenen Antworten, immer am Ende
appendix_open()
```
Die folgenden Abschnitte erklären die nummerierten Teile.
(1) Einstellungen
change_analysis_defaults() legt Voreinstellungen fest,
die für alle folgenden Auswertungen gelten, z. B. die Akzentfarbe der
Grafiken oder ob bei Single-Choice-Fragen auch eine Grafik erscheint
(show.plot.sc). Alle Einstellungen stehen unter
?setanalysis_defaults.
(2) Daten laden
Der Bericht liest die Dateien aus der Vorbereitung. Dadurch läuft das Einlesen nur einmal und nicht für jeden Bericht neu.
(3) Schalter setzen
Die Zeile des aktuellen Berichts enthält die Schalter aus 1.3.
list2env() macht daraus Variablen wie inkl.1.3
oder header2. Jede Auswertungsfunktion mit dem Argument
nr = "1.3" fragt dann die Variable inkl.1.3 ab
und gibt nur etwas aus, wenn sie TRUE ist. Ganze Abschnitte
(Überschrift und Fragen) blendet die Chunk-Option
#| eval: !expr header2 aus. Ohne nr oder mit
inkl = TRUE erscheint eine Frage immer.
(4) Daten auf den Bericht einschränken
Ein Bericht über einen Studiengang soll nur dessen Antworten zeigen. Beim Auswählen von Zeilen entfernt R aber die Attribute der Spalten, und ohne Fragetext und Antwortcodes funktionieren die Auswertungsfunktionen nicht richtig:
lve <- BspDaten$dataLVE
auswahl <- lve$Teilbereich == "Beispielkunde - SoSe24"

attr(lve[auswahl, ]$KF_01, "label")
#> NULL
Die kleine Hilfsfunktion zeilen_waehlen() aus dem Gerüst
überträgt die Attribute nach dem Auswählen wieder:
zeilen_waehlen <- function(daten, auswahl) {
  neu <- daten[auswahl, , drop = FALSE]
  for (spalte in names(daten)) {
    mostattributes(neu[[spalte]]) <- attributes(daten[[spalte]])
  }
  neu
}

attr(zeilen_waehlen(lve, auswahl)$KF_01, "label")
#> [1] "Didaktische Hilfsmittel (z.B. Folien, Begleitmaterialien) waren für mich hilfreich."
Die Einträge der Berichtstabelle (hier
bericht$Abschluss) sind Antworttexte; in den Daten stehen
Codes. Das Gerüst übersetzt den Text deshalb über das Attribut
labels in den passenden Code.
(5) Fragen auswerten
Die Auswertungsfunktionen schreiben Markdown bzw. Typst in die
Ausgabe. Sie stehen deshalb in Chunks mit #| output: asis.
Jede Funktion erzeugt Überschrift (aus dem Fragetext), Tabelle und, je
nach Fragetyp und Einstellungen, eine Grafik:
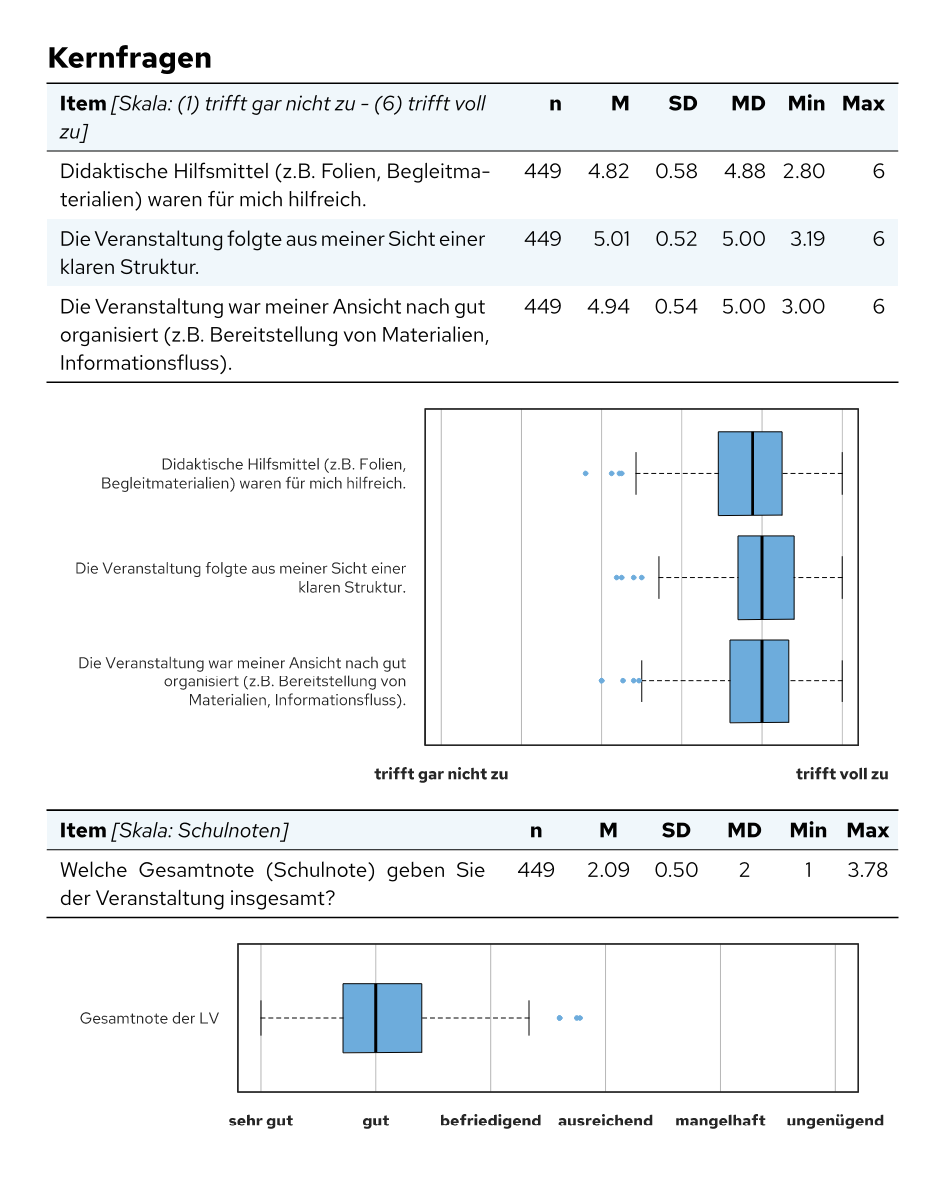
Welche Funktion zu welcher Frage passt, steht in der Übersicht unter Nachschlagen.
(6) Anhang mit den offenen Antworten
Bei open.appendix = TRUE erscheint an der Stelle einer
offenen Frage nur ein Link in den Anhang. appendix_open()
gibt am Ende alle gesammelten Antworten aus und leert danach den
Speicher, damit der nächste Bericht in derselben R-Sitzung neu beginnt.
Es gehört deshalb ans Ende jedes Berichts, auch wenn er keine offenen
Fragen enthält.
3. Alle Berichte erstellen
(alle-berichte-rendern.R)
Zum Schluss wird der Bericht für jede Zeile der Berichtstabelle
gerendert, jeweils mit dem passenden Parameter i:
library(quarto)

berichte <- readRDS("berichte.rds")

for (i in seq_len(nrow(berichte))) {
  quarto_render(
    input = "bericht.qmd",
    output_file = paste0(berichte$Dateiname[i], ".pdf"),
    execute_params = list(i = i)
  )
}
Das Beispielskript beispiele/alle-berichte-rendern.R in
set-template
ergänzt das um ein Protokoll der Stichprobengrößen, überspringt Berichte
mit zu wenigen Stimmen und macht nach einem Fehler mit dem nächsten
Bericht weiter.
Nachschlagen
Welche Funktion für welche Frage?
| Fragetyp | Funktion |
|---|---|
Single Choice ("sc") |
merge_sc(); Sonderfälle: merge_fachsem(),
merge_subj() (1. und 2. Fach) |
Multiple Choice ("mc") |
merge_mc() mit allen Spalten der Frage |
Skala ("sk") |
merge_sk(); mehrere Items gemeinsam:
merge_aggr_sk()
|
Zahlen ("open/num") |
merge_num() |
Offene Frage ("open/num") |
merge_open() |
| Kennwerte je Lehrveranstaltung |
merge_grade() (Gesamtnote), merge_wl()
(Workload), merge_rueck() (Rücklauf),
merge_aggr_sk(aggr = TRUE)
|
merge_auto() wählt die Funktion anhand des Attributs
type selbst, merge_many() wertet einen ganzen
Block von Spalten aus und fasst dabei die Spalten einer
Multiple-Choice-Frage zusammen:
merge_many(daten[, c("semester", "zufrieden", "abschluss_1", "abschluss_2", "kommentar")])Legenden
bsp_table_stat(), bsp_boxplot() und
bsp_evasys_sk6() erzeugen Erläuterungen zu den Kennwerten
und Grafiken, z. B. für einen Abschnitt „Hinweise zum Lesen des
Berichts“ am Ende.
Vorschau einer einzelnen Auswertung
In RStudio zeigt markdown_in_viewer() das Ergebnis einer
Auswertung im Viewer an, ohne den ganzen Bericht zu rendern:
markdown_in_viewer(merge_sc(BspDaten$dataLVE$V3_D))